不少朋友平时网上冲浪都试过跨地区听歌、看电影、玩游戏,一手“穿墙术”玩得驾轻就熟。锁区算什么,换个“梯子”不就解决了吗?起初我也这么想,后来意识到 AI 应用的封锁远比影音游戏的锁区严重得多。我想大家花一点时间来回顾几个关键新闻,应该能体会我的顾虑。
神仙打架关我什么事?
2025 年 9 月, 美国顶级 AI 公司 Anthropic (以下简称“A 社”) 修改了服务条款,明确禁止所有中国控股企业使用 Claude(含 API 与网页版)。限制范围覆盖中国大陆公司、海外中资子公司及云服务间接使用者。这一举动意味着 A 社已经做好舍弃中国市场的准备。
2026 年 2 月,A 社公开指控 DeepSeek、Moonshot AI、MiniMax 通过 24000 个虚假账号对 Claude 进行 1600 万+次对话,系统性提取模型能力用于训练自有模型。
2026 年 6 月, A 社 致函美国参议院银行委员会,指控阿里巴巴旗下千问团队通过约 25000 个虚假账号在 6 周内对 Claude 发起 2880 万次对话,为迄今已知最大规模“蒸馏攻击“。
同月,美国商务部工业与安全局 (BIS) 以国家安全理由下达出口管制指令,要求 Anthropic 立即限制所有外国公民(含在美国境内的外国人)使用它们的最前沿模型 Fable 5 和 Mythos 5。
2026 年 6 月底,大量中国个人订阅和团队用户被封禁。这一波不仅炸号,还炸出了大瓜:Anthropic 在它的 AI 编程智能体 Claude Code 植入隐蔽代码,监测用户地理位置并回传数据,帮助其精准封锁中国用户。这个监测机制率先被技术社区发现并曝光在 Reddit 论坛。后来,Anthropic 工程师 Thariq Shihipar 公开确认该代码存在,称其为”3 月上线的实验性反滥用功能”;同日 Claude Code 新版本发布,相关代码被移除。随后 BIS 取消了先前对 Fable 5 和 Mythos 的出口限制。
2026 年 7 月 3 日,阿里巴巴发现 Claude Code 内置地理标记系统之后发布内部通知,全面禁用该软件及 Claude 全系列模型。7 月 8 日,中国工信部下属网络安全信息共享平台(NVDB)发布安全通告,将这个版本的 Claude Code 列为”严重安全威胁”,呼吁立即卸载或升级。
路透社 7 月 7 日的报道透露,中国官方正考虑限制海外用户接入中国前沿模型。过去数月,阿里巴巴、字节跳动和智谱均参与了研讨。官方表示,泄漏、盗窃 AI 相关成果的行为触犯国家安全法例。
毫无疑问,中美两国都将前沿人工智能视为举足轻重的国家战略资源。随着封禁手段升级,矛盾越演越烈。在这期间,小红书上 Claude 用户的日常动态一边是炸号经历,另一边是“保命“、解封指南。有号的生怕自己被盯上,没号的纠结该不该注册?
美国其他头部 AI 供应商如 OpenAI、Google Gemini 其实也在服务条款内写明不在中国地区提供服务,只不过目前的封禁手段没 Anthropic 那么狠,暂时未见封号潮。
总而言之,作为一个没有技术背景的普通用户,我不想耗费多余的精力躲避越来越严密的封禁。AI 办公要长期使用,绝不能把它寄托在随时可能炸掉的账号。唯有国产模型能保证随时随地可调用。
够用还便宜 why not?
有人用惯了 ChatGPT、Gemini 或者豆包聊天,可能会担心国产模型不够智能,工作效果不理想。请问你是要造火箭吗?
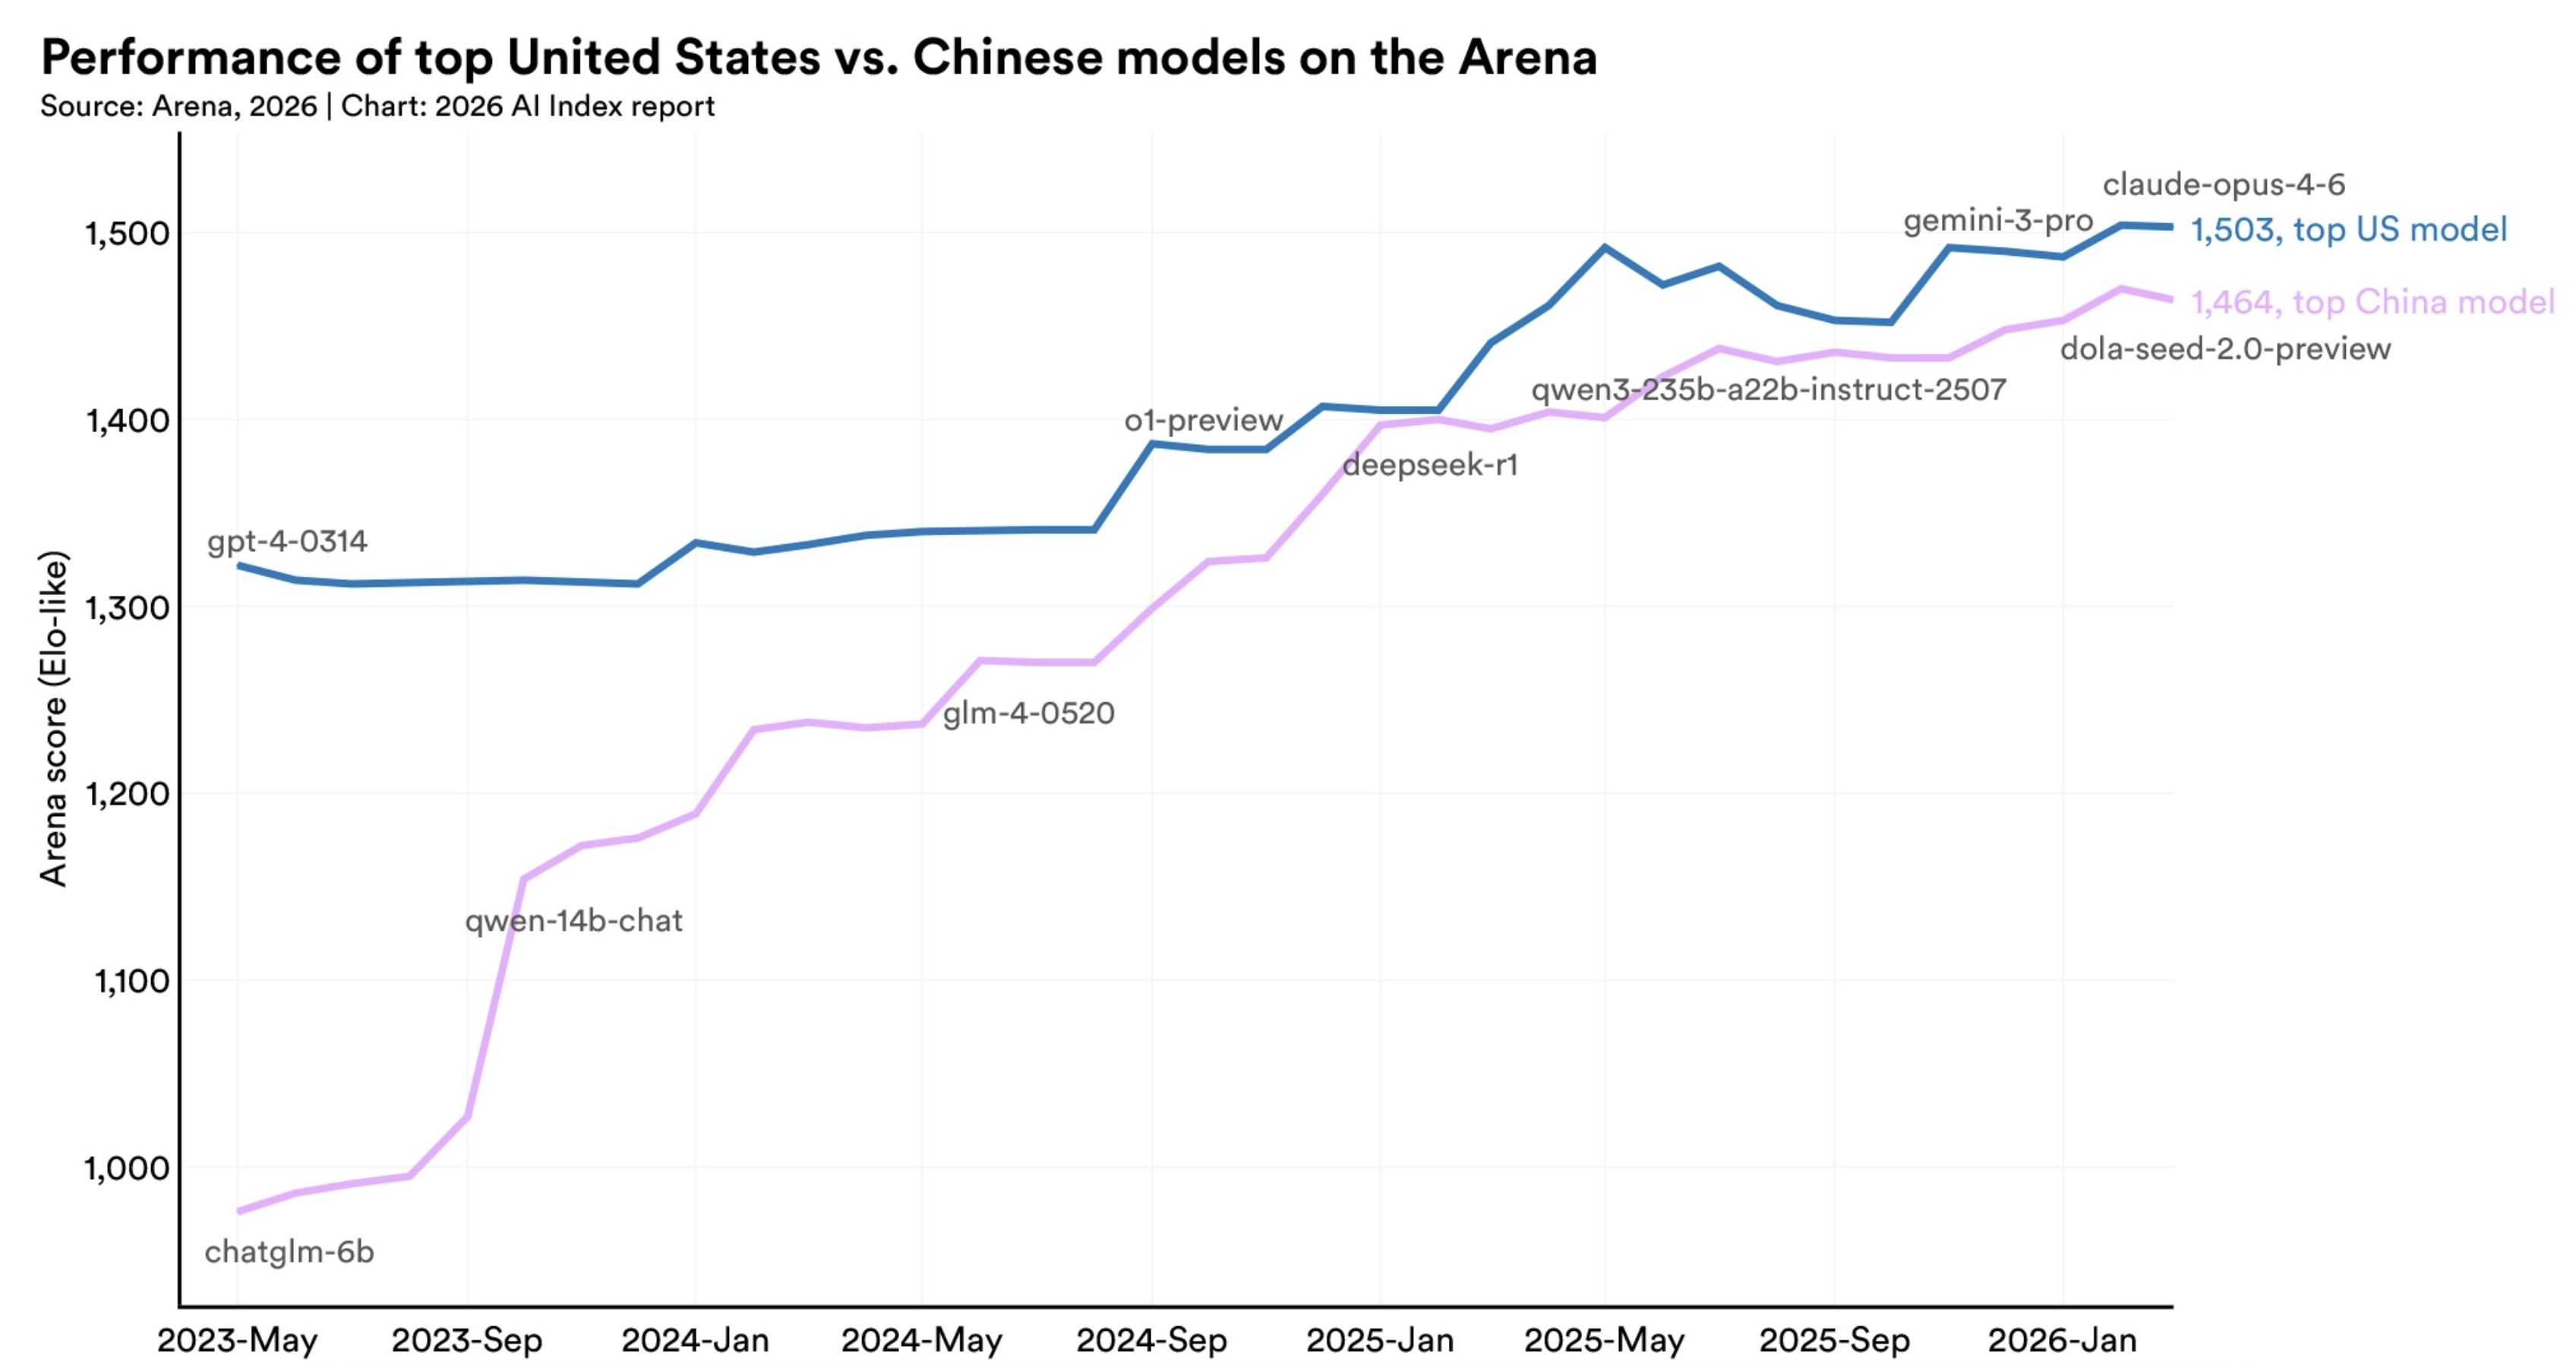
我们不妨看一组来自Stanford HAI Index 2026 的 AI 模型基准测试数据。图表显示,美国顶级模型与中国模型的成绩差距仅有 2.7%,两者能力几乎处于同等水平。不可否认,这一点差距在某些高端领域是成败的关键,例如:软件漏洞及网络安全排查、生物医学研究、基础物理实验等等。
可是我们普通人日常办公根本不涉及“高精尖”难题,手头上的任务只要具备以下三个条件,国产模型都能胜任:清晰的操作流程、明确的验收标准、可预判的例外状况对策。办公任务无需挑战模型的智能上限,最应该看重的是长上下文容量,多模态能力,可靠地遵从指令,操控电脑时不越权读写。
根据我最近几个月实际体验,国产模型已经全面嵌入了工作流。举几个例子吧,首先生产类的通常有:挖掘信息并交叉验证、去重、汇编,最终按预设的框架输出报告,原始数据转成可视化图形,文字档转成 PPT 提案等等;其次是电脑打杂:清理过期文档、批量移动或重命名之类的电脑打杂,诸如此类;最后还有简易编程,例如做个小工具,从 B 站自动下载整个播放列表内 100 条视频,全部转成音频档保存。
原本以为国产模型是“将就一下“,现在用得可顺手了,综合考虑性能、花费、网络延迟,找不出任何理由换国外模型。我的常用组合是:MiMo V2.5 + DeepSeek V4 Flash/Pro + Qwen 3.7 Plus + GLM 5.2。不同模型分配不同类型任务,搭配其他 agent 或 harness 使用。具体的配置细节和操作技巧又是另一个话题了,先按下不表。
国产模型的价格到底便宜多少?以下表格供大家参考:
| 模型 | 产地 | 输入 / 1M | 输出 / 1M | vs GPT-5.6 输入 | vs GPT-5.6 输出 |
|---|---|---|---|---|---|
| GPT-5.6 Terra | 🇺🇸 | ¥13.5 | ¥80.8 | 基准 | 基准 |
| Claude Opus 4.7 | 🇺🇸 | ¥33.7 | ¥168.3 | 贵 2.5 倍 | 贵 2.1 倍 |
| GLM 5.2 | 🇨🇳 | ¥9.4 | ¥29.6 | 便宜 1.4 倍 | 便宜 2.7 倍 |
| DeepSeek V4 Pro(忙时) | 🇨🇳 | ¥8.9 | ¥26.7 | 便宜 1.5 倍 | 便宜 3 倍 |
| Meituan LongCat-2.0 | 🇨🇳 | ¥5.0 | ¥19.9 | 便宜 2.7 倍 | 便宜 4 倍 |
| DeepSeek V4 Pro(闲时) | 🇨🇳 | ¥4.4 | ¥13.3 | 便宜 3 倍 | 便宜 6 倍 |
| DeepSeek V4 Flash(忙时) | 🇨🇳 | ¥3.0 | ¥8.9 | 便宜 5 倍 | 便宜 9 倍 |
| Qwen3.7 Plus | 🇨🇳 | ¥2.2 | ¥8.6 | 便宜 6 倍 | 便宜 9 倍 |
| MiniMax M2.7 | 🇨🇳 | ¥1.6 | ¥6.5 | 便宜 8 倍 | 便宜 13 倍 |
| DeepSeek V4 Flash(闲时) | 🇨🇳 | ¥1.5 | ¥4.4 | 便宜 9 倍 | 便宜 18 倍 |
| MiMo V2.5 | 🇨🇳 | ¥0.9 | ¥1.9 | 便宜 14 倍 | 便宜 43 倍 |
备注
- DeepSeek 分闲时/忙时定价:忙时包括上午九点至中午十二点、下午两点至六点,其余时段均为闲时
- 美国模型价格按官方 API 美元报价换算,汇率 $1 ≈ ¥6.73(2026-08-20)
更新备注
我换模型啦,以前交给 DeepSeek V4 处理的任务,现在全部由GLM 5.3 代替
国产“御三家“,闭眼选
说了这么多,其实最直接的上手建议是先找个国产 AI 办公软件用起来——先不管什么基准测试报告,模型架构之类的技术细节。
国产“御三家”挑一个,你常用的协作软件是哪家,就选它同厂的 AI 办公:用企业微信,选腾讯 WorkBuddy;用飞书,选豆包工作;用钉钉,选千问办公。
拿你的真实任务测试 AI 能力,检视自己的工作流程,调整预期,什么事交给 AI,什么事自己做,划清权限边界。实际效果可能是自己提升了效率,瓶颈卡在同事那里,整体效率快不了多少。 🥲 关于组织如何 AI 转型又是另一个话题了,以后再聊。
总而言之,选 AI 工具就如买鞋子,产品广告和资料可以看,第三方的真人评测可以看,但决定性的因素还是自己实际上脚的感受。一双鞋好不好穿,合不合适,没人能替你做选择,亲自摸索的功夫不能省。
P.S.
如果你不介意动手折腾,需要用外国模型,可以了解下 sub2api,是一个中转服务。今天刷到 Codex 官方人员发推 点名,给它打了个“免费广告“。我没用过,只是随手分享。请各位务必做好调查,千万千万不要看价格便宜就冲。中转站这玩意儿跟“灰产”的关联千丝万缕,一定要擦亮眼睛。和别人共用 Spotify、Netflix 大不了暴露品味,但是共用 AI 帐号,可泄漏的隐私就多啰。