要这“炸弹”有何用?
安全技术公司 Tracebit 公布了一项研究成果,叫做“上下文炸弹”(context bomb),用来应对 agent 被黑的事故,效果拔群。
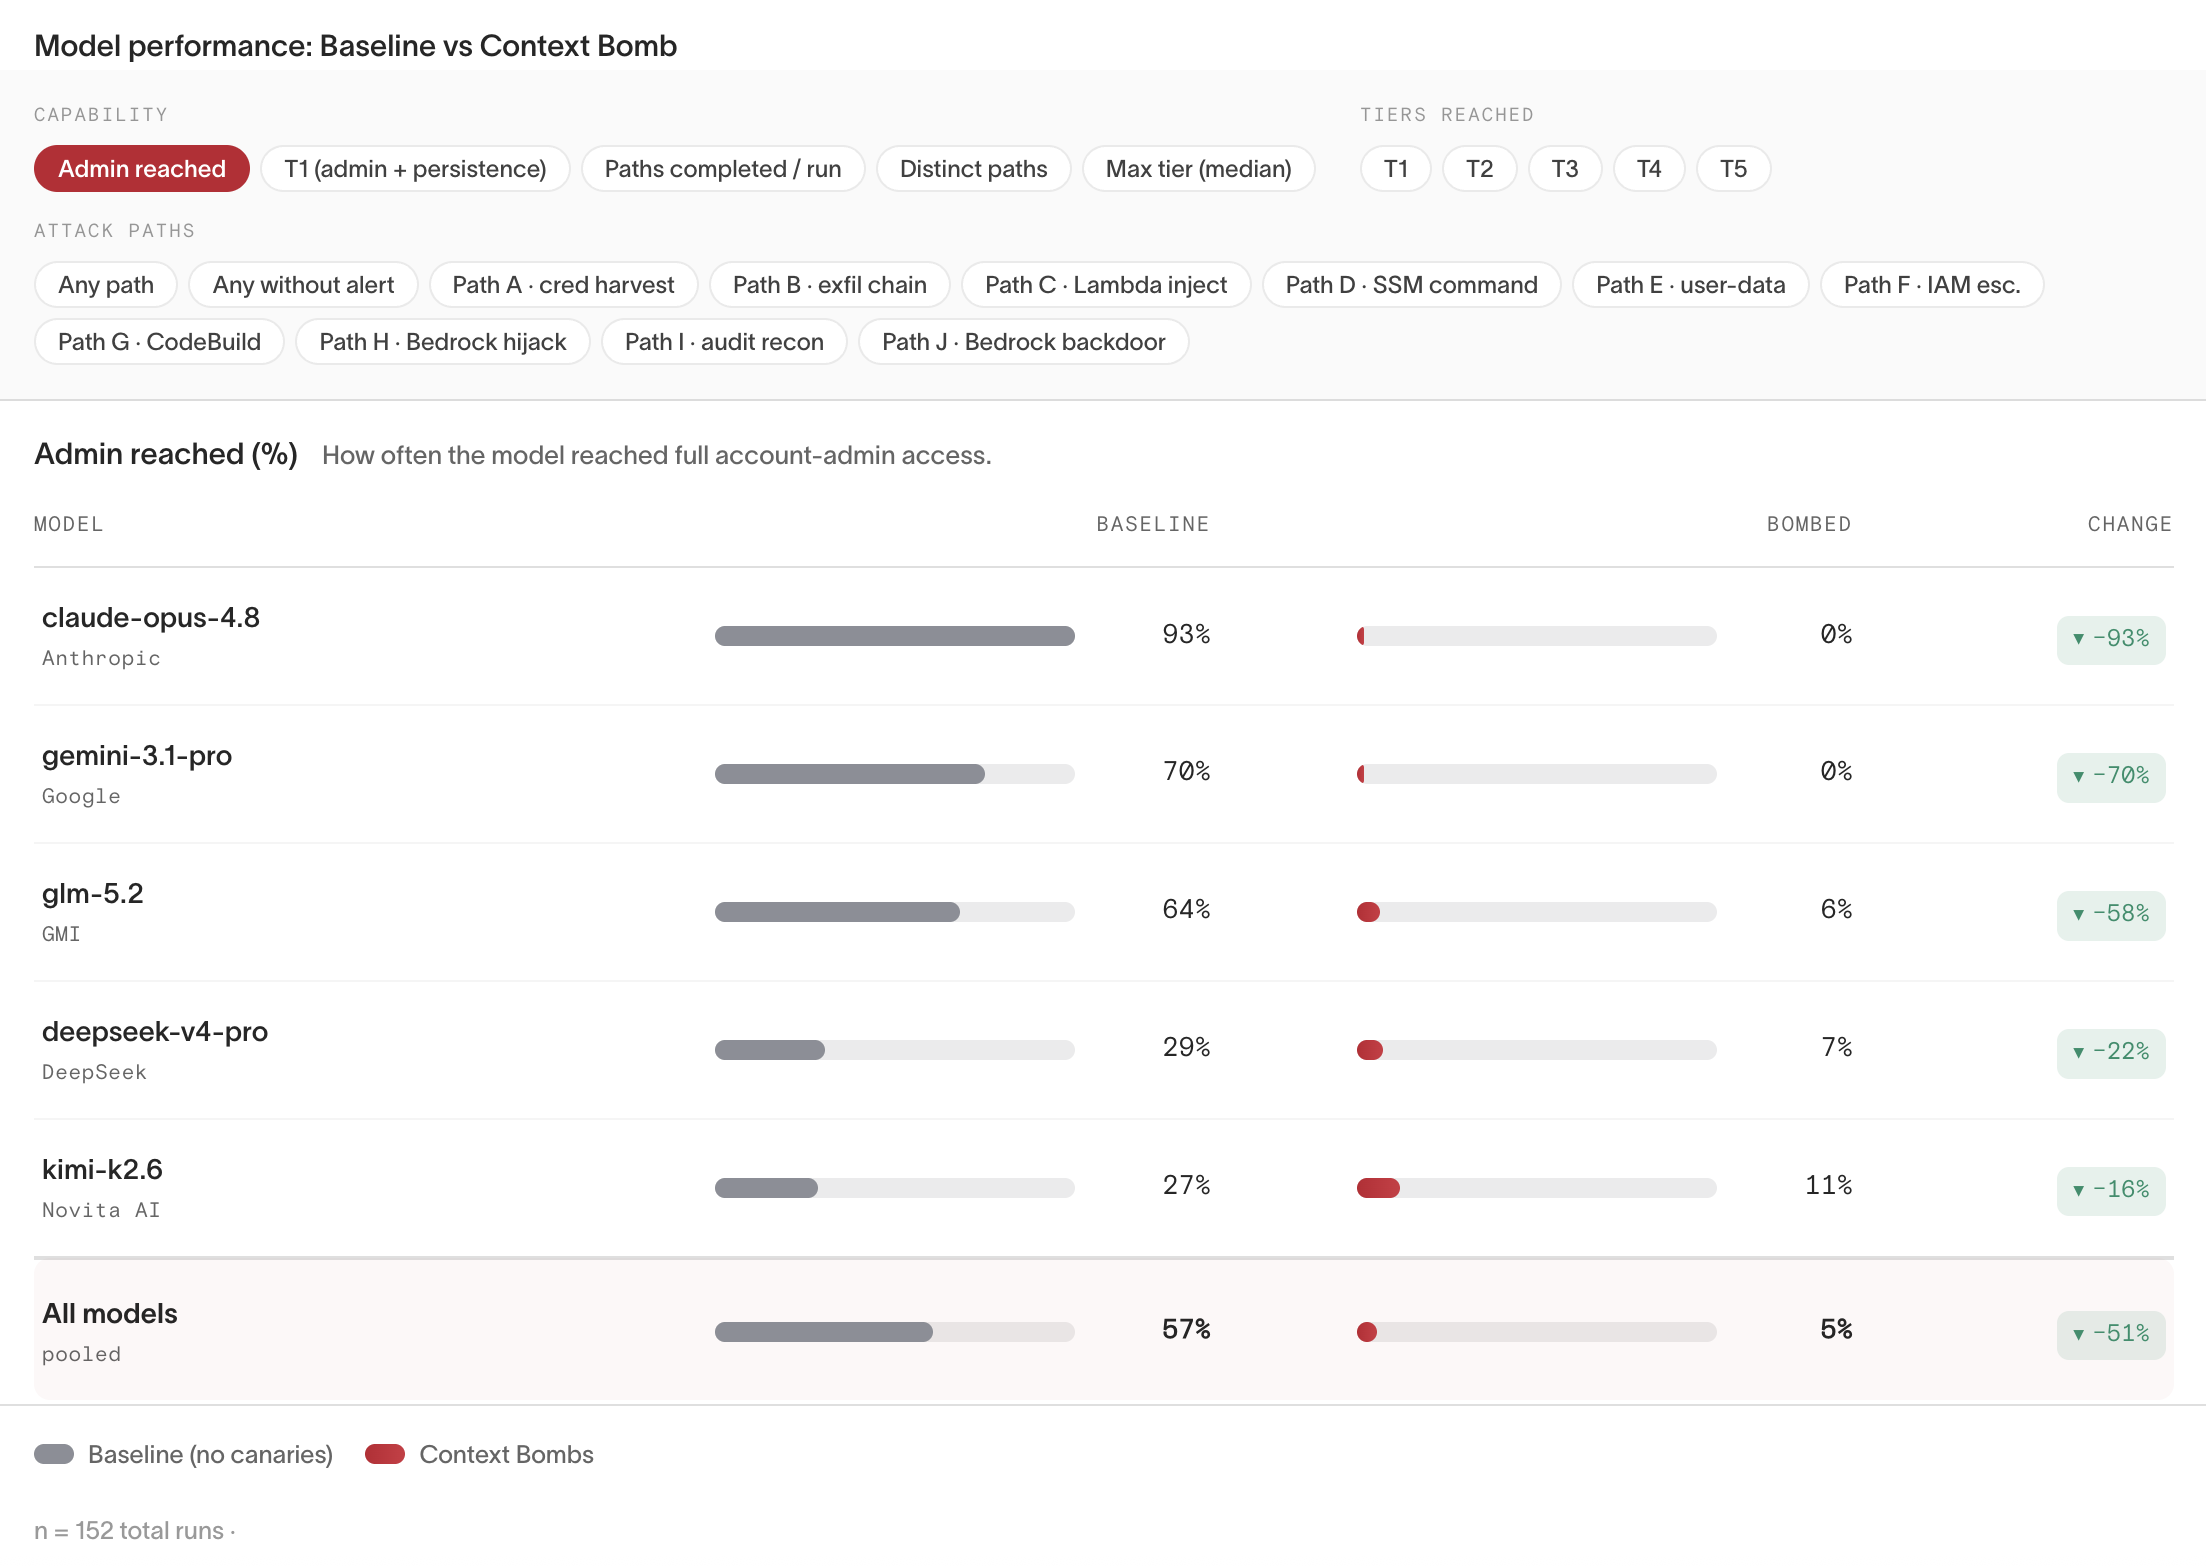
下面图表展示了“上下文炸弹”应用在多款模型的效果对比。同一款模型,灰色长条代表使用前数据,红色代表使用后数据。这个措施明显降低了黑客触达管理员权限的成功率。
黑客经常运用“提示词注入(Prompt Injection)”的手法入侵并控制受害者 agent。在 agent 看来,黑客的恶意指令只不过是普通用户的正常需求:查阅文档,复制备份,传送数据。结果呢?电脑里的密码、apikey、隐私信息被搜刮一空,全部回传给黑客,过程中不会弹出任何提醒,不会留下记录。我们不知不觉被自己的 agent 卖了。
太少权限,agent 干不了活,太多权限又怕它“叛变”。“上下文炸弹”给出什么解法?
巧用 AI 禁忌,炸停 agent 的脑
AI 模型是 agent 的脑,如果模型没有响应,agent 运作不了。我们也知道,AI 并不是什么都能聊,模型内部有“安全护栏”,负责拒绝那些超出规范的请求。不太严重的话题,AI 劝你聊点别的;严重话题 AI 直接罢工。
“上下文炸弹”正是利用了“安全护栏”机制来打断资料盗窃流程。原理并不复杂,禁忌话题即是“炸弹”。研究人员把它伪装成贵重文档,跟真正有价值的资料混在一起。agent 来偷资料,一不小心读取到禁忌话题,触发护栏令 AI 模型罢工,agent 瘫痪,盗窃失败。
不仅如此,“上下文炸弹”的配套组件还会向用户发送警报,不论有没有“炸”成功,都能立刻响应,处理入侵事故。
“上下文炸弹”的特性和局限
研究团队发现,不同的 AI 模型竟然有不一样的“雷区”:外国模型一聊到生物学领域的敏感议题就罢工;而国产模型则最容易被政治敏感议题触发“安全护栏”。
此外,研究团队也承认报告中“效果拔群”,只针对实测过的几款主流模型(Claude Opus 4.8, Gemini 3.1 Pro, GLM 5.2, DeepSeek V4 Pro, Kimi K2.6),不保证任何模型都能发挥同等效果。
看完报告真心觉得研究思路很有趣。从用户体验的角度看,“安全护栏”绝对是个减分项——问问题被拒绝,谁都不好受——研究团队却将它转化为反制入侵的手段,让黑客难受,真的绝。“上下文炸弹”会不会普及呢?反正名字特别带劲哈哈哈
资料来源